IA para leer PDF y facturas: extraer datos
Cómo usar IA para leer PDF y facturas y extraer datos a una planilla: qué campos pedir, qué falla con escaneos y cómo comprobar cada total.
Fundador de JustSEO, agencia de Providencia que monta sitios y trabaja con IA a diario
Publicado el
6 min de lectura
En este artículo
- ¿Cómo funciona la IA para leer un PDF?
- ¿Qué diferencia hay entre un PDF de texto y un escaneo?
- ¿Qué límites de tamaño tiene?
- ¿Cómo extraigo datos de un PDF paso a paso?
- ¿Cómo compruebo que los datos salieron bien?
- ¿Qué pasa con los datos personales de los documentos?
- ¿Cuándo no conviene usar IA para leer documentos?
- Preguntas frecuentes
- Fuentes
Para usar IA para leer PDF y sacar sus datos, sube el documento a un asistente, dile qué campos quieres (fecha, proveedor, líneas, total), pide el resultado en una tabla y marca «no encontrado» cuando falte algo. Después comprueba que la suma de las líneas dé el total del documento. Con PDF de texto funciona bien; con escaneos o fotos hay que revisar más.
Vigente al 11 de noviembre de 2026.
Extraer datos con IA es pedirle a un asistente que lea un documento, como la factura de un proveedor, una cotización o una orden de compra, y devuelva solo los campos que necesitas en un formato ordenado, como una tabla.
Claude es marca de Anthropic y ChatGPT es marca de OpenAI. JustSEO no está afiliada ni patrocinada por ellas. ChatGPT no lo probamos para leer documentos: resumen de fuentes oficiales al 11 de noviembre de 2026. En esta entrada no tratamos materia tributaria ni contable: solo cómo sacar datos de un documento a una planilla.
¿Cómo funciona la IA para leer un PDF?
Una IA lee el PDF como texto y como imagen de cada página. En la documentación de Anthropic, cada página se procesa como imagen además del texto que se extrae, por eso Claude puede interpretar gráficos y tablas, y por eso queda sujeto a las mismas limitaciones que la visión en general (Anthropic, consultada el 11 de noviembre de 2026).
Ese límite importa para documentos reales. La misma documentación advierte que Claude puede equivocarse o inventar datos al interpretar imágenes de baja calidad, rotadas o muy pequeñas, y que sus conteos y ubicaciones son aproximados (Anthropic, consultada el 11 de noviembre de 2026). Sobre ChatGPT y las tablas dentro de imágenes o escaneos, según su documentación, que conviene revisar, hay una guía de OpenAI guía de OpenAI.
¿Qué diferencia hay entre un PDF de texto y un escaneo?
Un PDF de texto se puede seleccionar con el cursor; un escaneo es una foto de la hoja. La diferencia decide cuánto revisar.
| Tipo de documento | Cómo reconocerlo | Riesgo de error | Qué hacer |
|---|---|---|---|
| PDF de texto (descargado del sistema del proveedor) | Puedes seleccionar y copiar el texto | Menor | Revisar totales y una muestra |
| PDF escaneado | El texto no se selecciona; parece una foto | Mayor | Revisar cada campo crítico a mano |
| Foto con el celular | Bordes, sombras, hoja torcida | Mayor | Pedir el original digital; si no, revisar todo |
| PDF con contraseña | Pide clave al abrir | No se puede leer | La documentación de Claude pide PDF sin contraseñas ni cifrado |
¿Qué límites de tamaño tiene?
Depende de la herramienta. En la API de Claude, la documentación fija un máximo de 128 MB por solicitud y 600 páginas (100 cuando la ventana de contexto es menor a 1 millón de tokens), con PDF estándar, sin contraseñas. Anthropic agrega que los PDF densos, con letra chica, tablas complejas o muchos gráficos, pueden llenar la ventana de contexto antes de llegar al límite de páginas, y sugiere dividir el documento en secciones (Anthropic, consultada el 11 de noviembre de 2026).
En los chats (ChatGPT, Claude) los límites son por plan y cambian. Revisa la página de ayuda del proveedor el día que lo uses.
¿Cómo extraigo datos de un PDF paso a paso?
Hazlo en cinco pasos, con un documento de ejemplo antes de tocar uno real.
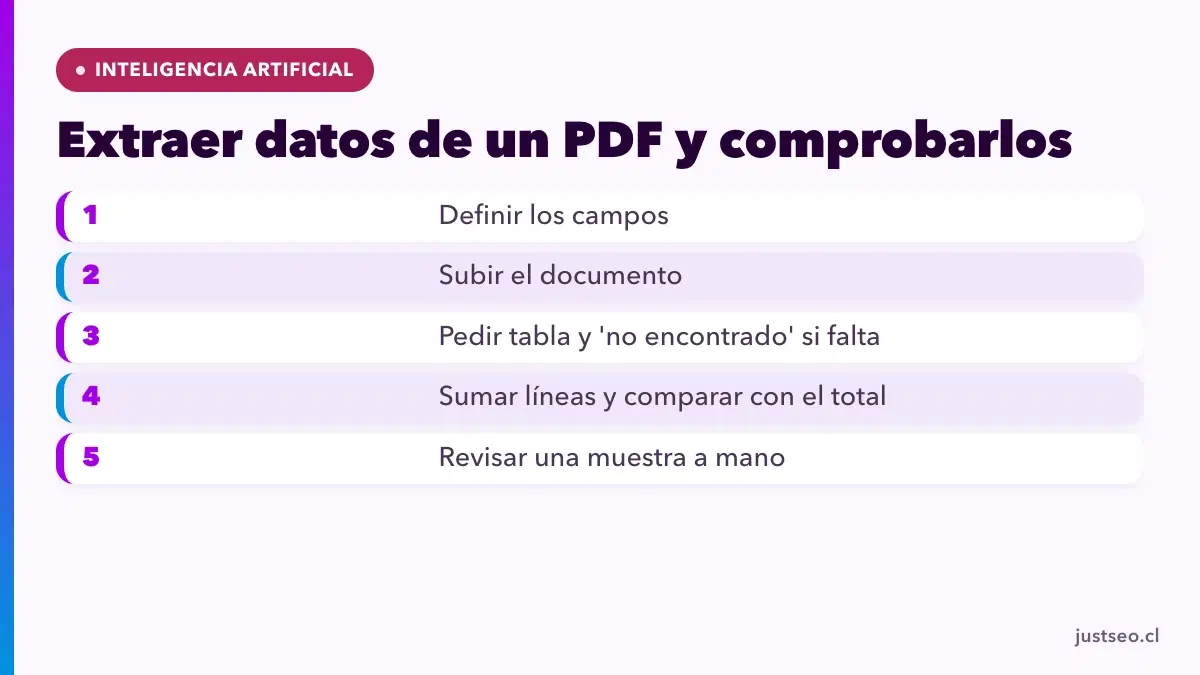
- Define los campos. Escribe qué quieres: número de documento, fecha, nombre del proveedor, líneas (descripción, cantidad, precio unitario, subtotal de la línea) y total.
- Sube el documento a un asistente que acepte PDF.
- Pide el resultado en tabla y dile qué hacer con lo que falta.
- Pide una comprobación interna: que sume las líneas y compare con el total del documento.
- Verifica tú con el original abierto al lado.
Un mensaje de ejemplo, para un documento de proveedor ficticio:
Lee este PDF y devuélveme una tabla con estas columnas: número de documento, fecha, proveedor, y por cada línea: descripción, cantidad, precio unitario y subtotal. Después, una fila aparte con el total del documento. Si un campo no aparece, escribe «no encontrado»; no lo deduzcas. Al final, suma los subtotales de las líneas y dime si coinciden con el total.
Las instrucciones «no lo deduzcas» y «no encontrado» importan. Sin ellas, un asistente tiende a rellenar un campo vacío con algo plausible.
Lo hacemos contigo en JustSEOSi tu equipo pasa horas digitando datos de documentos a planillas, te mostramos en un taller cómo pedirlos y comprobarlos con IA.El diagnóstico inicial no tiene costo.Ver la capacitación en IA¿Cómo compruebo que los datos salieron bien?
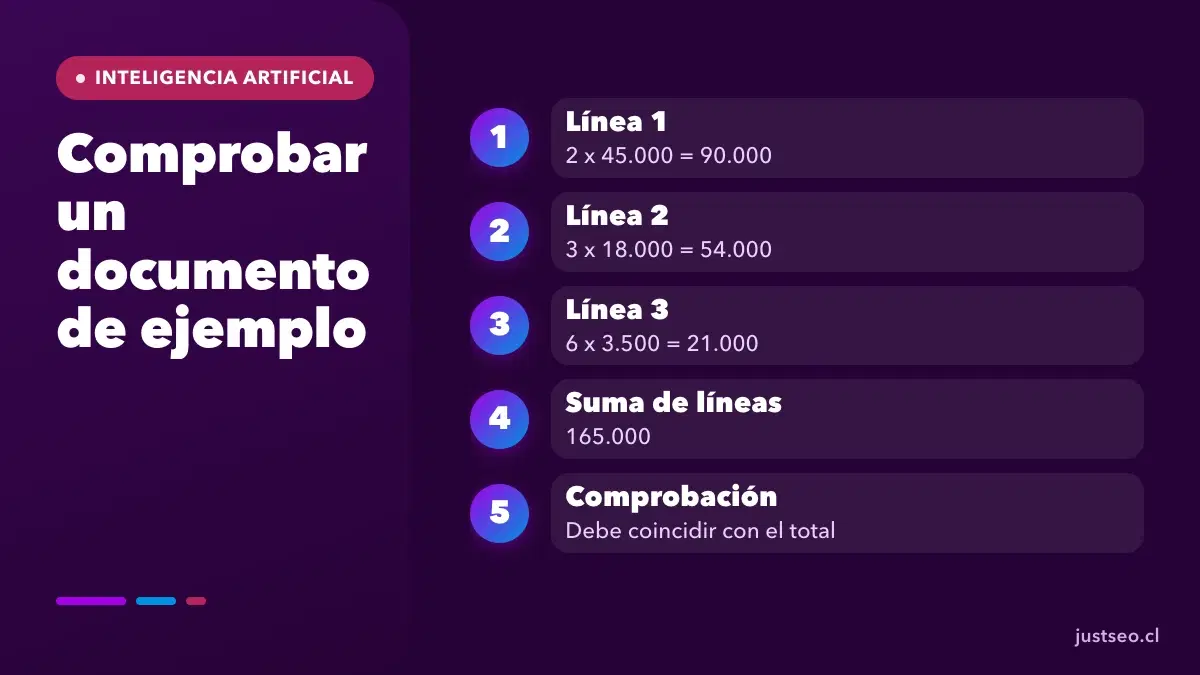
Compara siempre contra el original, con controles baratos. En un documento de proveedor de ejemplo con tres líneas (2 × 45.000, 3 × 18.000 y 6 × 3.500), los subtotales son 90.000, 54.000 y 21.000, y la suma de las líneas debe dar 165.000. Si el asistente extrae otro total, hay una línea mal leída o una omitida.
Controles que recomendamos:
- Suma de líneas contra total. Lo más útil y lo más rápido.
- Cantidad × precio = subtotal en cada línea.
- Fechas y números de documento contra el original: son campos cortos donde un dígito cambiado pasa desapercibido.
- Campos marcados «no encontrado». Revísalos: a veces el dato está y no lo vio.
- Muestra continua. Revisa a mano los primeros documentos de cada proveedor nuevo y una muestra de los siguientes.
Si vas a extraer cientos de documentos, la lógica es la misma que en análisis de datos con IA: el asistente propone, una regla simple verifica, y una persona responde.
¿Qué pasa con los datos personales de los documentos?
Quita lo que no necesitas antes de subir. Para extraer montos y fechas no hace falta el nombre ni el RUT de una persona (en los ejemplos de esta entrada, son datos inventados). Si los documentos traen datos de personas, antes revisa nuestro resumen sobre la ley de datos personales y lo que cada proveedor hace con los archivos que subes.
Desde la práctica: en la agencia, un validador por script y una segunda lectura revisan nuestros textos, y una persona firma. Para extraer datos, el equivalente es tu control de totales y tu muestra manual.
¿Cuándo no conviene usar IA para leer documentos?
No conviene cuando el costo de un error es alto y no hay forma de comprobarlo. Un número de cuenta, un monto que se va a pagar o un dato que va a un documento oficial deben verificarse contra el original siempre, aunque el asistente lo haya extraído bien cien veces seguidas.
Tampoco conviene cuando el volumen es bajo: tipear tres documentos al mes es más rápido que montar un flujo. La IA rinde cuando el mismo tipo de documento llega todas las semanas. Si ese es tu caso, mira cómo ordenar el proceso completo en automatizar procesos con IA en una pyme, revisa el directorio de herramientas de IA y, si quieres que tu equipo lo aprenda con sus propios documentos, la capacitación en IA.
Redactado con apoyo de IA y revisado por una persona. Cómo escribimos.
Preguntas frecuentes
¿Puede la IA leer un PDF y pasar sus datos a Excel?
Sí. Claude acepta PDF, según la documentación de Anthropic, y puede devolver los campos que pidas en una tabla que luego copias a una planilla; en otros asistentes, revisa su documentación. Funciona mejor con PDF de texto que con escaneos. Define qué campos quieres, pide la respuesta en columnas y comprueba los totales antes de usar los datos.
¿Qué pasa con los PDF escaneados o fotos de documentos?
Tienen más riesgo de error. La documentación de Anthropic indica que Claude puede equivocarse con imágenes de baja calidad, rotadas o muy pequeñas, y lo mismo vale para cualquier asistente con tablas dentro de una imagen. Si puedes, pide el documento original en digital o revisa cada campo a mano.
¿Cuántas páginas puede leer una IA en un PDF?
Depende de la herramienta. En la API de Claude, la documentación fija hasta 600 páginas por solicitud (100 cuando la ventana de contexto es menor a 1 millón de tokens) y 128 MB, sin contraseñas ni cifrado. En los chats, los límites por plan son otros. Para archivos grandes, divide el PDF por secciones.
¿Es seguro subir documentos de clientes a una IA?
Depende del plan, de lo que contenga el documento y de las políticas de cada proveedor. Antes de subir, quita datos personales que no necesites y revisa qué hace la herramienta con tus archivos. Si el documento trae datos de personas, lee nuestro resumen sobre la ley de datos personales y consulta con quien administra tus sistemas.
¿Cómo sé que la IA no cambió un número al extraer los datos?
Verificando. Suma las líneas del documento y compara con el total que extrajo, revisa fechas y números de documento contra el original y pide que marque «no encontrado» cuando un campo no aparece. Revisa a mano los primeros documentos de cada proveedor nuevo y una muestra de los siguientes.
Fuentes
Escrito por
Yamil Alfonzo
Fundador de JustSEO, agencia de Providencia que monta sitios y trabaja con IA a diario
Ver perfil en LinkedIn